HBM 고도화와 3D 적층 D램·HBF 개발 병행 청사진 제시
개별 제품 넘어 메모리 계층 전체 최적화 추진
개별 제품 넘어 메모리 계층 전체 최적화 추진
|
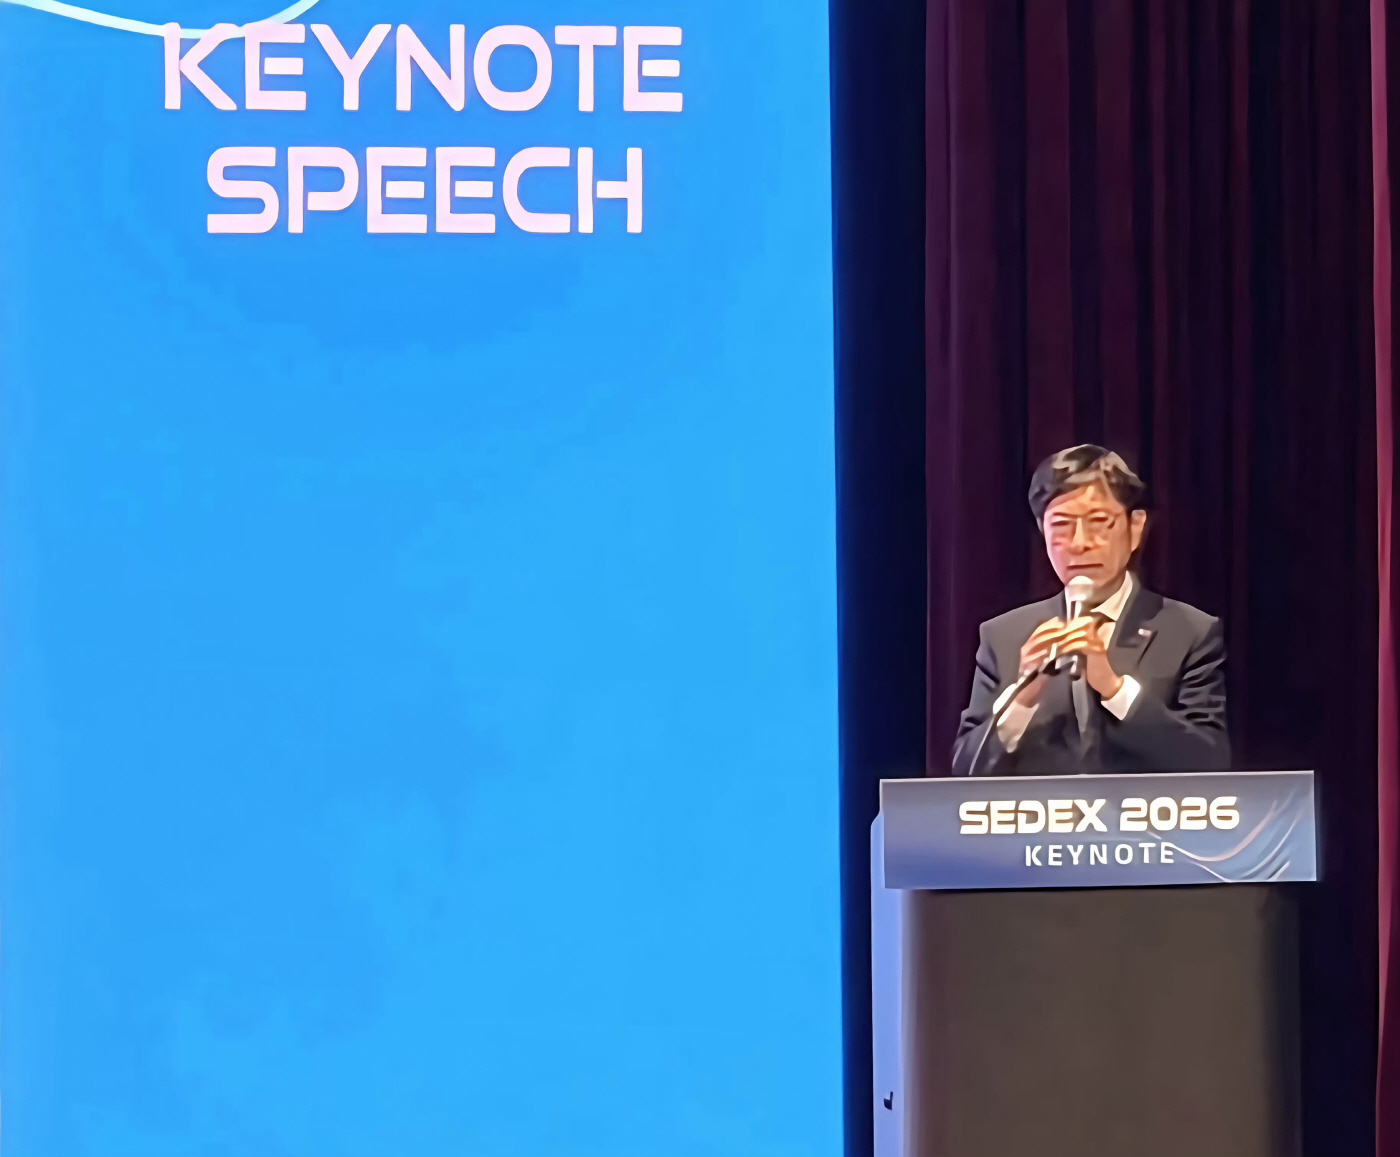
안 사장은 14일 서울 강남구 코엑스에서 열린 '반도체대전(SEDEX) 2026' 기조연설에서 AI의 발전 속도에 대해 "인류가 경험하지 못한 정도로 성장하고 있고, 과거의 속도로 설명할 수 없을 정도로 빨라지고 있다"고 말했다.
'AI 시대, 메모리 기술의 진화 방향'을 주제로 발표한 안 사장은 빅테크 기업들의 AI 투자가 지속 확대되고 있다며, AI 인프라의 성능 규모가 2030년에는 올해 대비 약 19배로 커질 것으로 전망했다. AI 기술의 효율화가 비용 절감에 그치지 않고 활용 확대와 새로운 수요 창출로 이어지고 있다는 분석이다.
특히 AI 추론 수요는 작업의 복잡도와 처리해야 할 문맥의 길이, 추론 요청량이 동시에 증가하는 형태로 커지고 있다고 설명했다. 이들 요인이 서로 곱해지며 연산 수요뿐 아니라 데이터를 저장하고 이동하는 데 필요한 메모리 수요도 구조적으로 확대한다는 것이다.
이 과정에서 중요한 과제로 떠오른 것이 '키밸류(KV) 캐시' 관리다. KV 캐시는 AI가 앞서 처리한 토큰 정보를 저장하고 재활용하는 데이터로, 처리하는 문맥이 길어질수록 필요한 메모리 용량도 늘어난다. 대규모 데이터를 HBM과 D램, SSD 등 여러 계층에 분산해 저장하면 계층 사이의 데이터 이동이 증가하면서 성능 저하와 전력 소모를 유발할 수 있다.
안 사장은 "처리 데이터가 늘어나며 메모리 계층 간 데이터 이동이 중요해지는 상황에서, 데이터 이동의 병목 해소가 중요하다"고 짚었다. 과거에는 연산기와 메모리 사이의 성능 격차가 주요 문제였다면, 이제는 서로 다른 메모리 계층 사이의 데이터 이동까지 최적화해야 한다는 설명이다.
SK하이닉스는 이에 대응해 HBM의 용량과 대역폭, 에너지 효율을 높이는 한편 고객별 AI 시스템에 맞춘 '커스텀 HBM(CHBM)' 개발을 추진한다. 베이스다이에 메모리 컨트롤러와 고객이 요구하는 로직을 탑재해 AI 시스템의 구조와 용도에 맞춰 기능을 최적화하는 방식이다. 내년 CHBM4E부터 시장에 내놓을 계획이다.
연산기와 메모리의 물리적 거리를 줄이는 '3D Stacked DRAM'도 차세대 기술로 제시했다. GPU·NPU 등 로직 반도체 위에 D램을 쌓아 필요한 데이터를 연산기에 가까운 곳에서 공급하는 구조다. SK하이닉스는 이를 통해 대규모 AI 모델의 추론 성능을 높이고 데이터 이동에 소모되는 에너지를 줄인다는 방향을 제시했다.
증가하는 메모리 용량 수요에는 HBF로 대응한다. HBF는 HBM 개발 과정에서 확보한 실리콘관통전극(TSV) 적층과 고속 입출력 기술을 낸드플래시에 적용하는 차세대 메모리다. HBM과 D램 사이에 새로운 계층을 마련해 높은 대역폭과 대용량을 함께 제공하는 것이 목표다.
SK하이닉스는 HBF의 개발 목표로 동세대 HBM 대비 절반 수준의 대역폭과 약 10배의 용량을 제시했다. AI 연산에 필요한 대량의 데이터를 연산기 가까이에 저장해 D램과 SSD에 접근하는 부담을 줄이고, 시스템 전체의 성능과 에너지 효율을 높이겠다는 구상이다. 안 사장은 대규모 데이터를 반복적으로 읽는 작업이 많은 AI 추론의 특성이 낸드 기반 HBF에 적합하다고 설명했다.
새로운 메모리 기술의 확산을 위한 표준화와 파트너 협력도 추진한다. 안 사장은 샌디스크와의 협력에 더해 DSP·XPU 업체 등과 협력해 HBF 규격 0.7 버전을 공개했으며, 내년 1월 최종 규격을 공개할 예정이라고 밝혔다. 이를 통해 새로운 메모리 계층을 구현할 기술 기반과 생태계를 함께 구축한다는 구상이다.
안 사장은 AI 모델을 중심으로 시스템을 설계하는 만큼, 작업별로 필요한 성능과 용량, 대역폭을 함께 고려하는 협력이 중요하다고 강조했다. AI가 촉발한 기술·산업 변화에 대응해 국내 기업들과 각자의 영역에서 협업하며 새로운 기회를 확보하겠다는 방향도 제시했다.